Orquestração de agentes de IA: arquitetura, padrões e boas práticas
Como coordenar vários agentes de IA em produção: padrões hierárquico, pipeline e mesh, camadas da arquitetura, checklist de produção, frameworks e quando contratar uma plataforma.
TL;DR
Orquestração de agentes de IA é a coordenação de agentes especializados por um orquestrador que decide quem age, em que ordem, com qual contexto e quando chamar uma pessoa. Os padrões mais usados são hierárquico, pipeline e mesh; em produção, o que decide o resultado é observabilidade, limites, timeouts, custo e transferência para humanos com contexto.
Compartilhar
Um agente de IA generalista que tenta fazer tudo costuma fazer tudo pela metade. É como contratar uma pessoa para ser atendente, analista financeiro e gerente de conta ao mesmo tempo.
A saída que aparece nos projetos que chegam à produção é outra: agentes especializados, cada um com seu domínio, coordenados por um orquestrador que sabe qual chamar, em que ordem e com qual contexto. É essa arquitetura que separa a agentic AI de um chatbot que só responde perguntas. Se você está começando, leia antes o que é um agente de IA.
Este guia, para CTOs, arquitetos e líderes de operação, cobre padrões, camadas, um exemplo ponta a ponta, um checklist de produção e quando contratar em vez de construir.
Atualizado em novembro de 2026.
O que é orquestração de agentes de IA (e o que não é)
Orquestração de agentes de IA é a coordenação de agentes autônomos e especializados em torno de um objetivo, em que um orquestrador decide qual agente ativar, em que ordem, com qual contexto e como juntar os resultados em uma resposta coerente. O conjunto desses agentes é um sistema multiagente.
Orquestração não é encadear prompts em ordem fixa nem dar ferramentas a um chatbot. Um sistema sequencial executa A, B e C sempre na mesma ordem; um sistema orquestrado decide se A e C rodam em paralelo, se B é necessário e se é hora de chamar uma pessoa antes de C.


A Anthropic faz uma distinção útil no artigo Building effective agents (19 de dezembro de 2024): workflows seguem caminhos definidos em código, enquanto agentes decidem os próprios passos. O mesmo texto recomenda "encontrar a solução mais simples possível e só aumentar a complexidade quando necessário". Orquestração boa mistura os dois: caminho fixo onde a regra é clara, decisão do modelo onde a conversa é aberta.
Quais são os padrões de orquestração de agentes?
Três padrões cobrem a maior parte dos projetos de negócio: hierárquico (um supervisor delega a especialistas), pipeline (cada agente passa o resultado ao próximo) e mesh (agentes conversam entre si sem centro). A escolha depende de quão previsível é a tarefa e de quanto você precisa auditar cada passo.
| Padrão | Como funciona | Quando usar | Principal risco |
|---|---|---|---|
| Hierárquico (supervisor e especialistas) | O orquestrador identifica a intenção e delega ao agente certo; o roteador central é a versão mais simples | Atendimento com domínios distintos (suporte, cobrança, vendas) | O supervisor vira gargalo e ponto único de erro de roteamento |
| Pipeline (cascata) | A saída de um agente é a entrada do próximo, em ordem fixa | Processos com etapas auditáveis: onboarding, documentos, qualificação | Latência acumulada e erro de uma etapa propagado às seguintes |
| Mesh (colaboração descentralizada) | Agentes pedem informação uns aos outros, sem orquestrador central | Pesquisa e diagnóstico abertos, em que a sequência não é previsível | Difícil de depurar, auditar e controlar custo |
Hierárquico: supervisor e agentes especializados
É o padrão mais adequado para atendimento ao cliente: o orquestrador identifica a intenção, chama o especialista e consolida o resultado.
Carregando diagrama
Cada especialista é testável sozinho, e um caso de uso novo vira um agente novo sem mexer nos existentes.
Pipeline: processamento em cascata
Cada agente alimenta o próximo, em ordem fixa e auditável etapa por etapa.
Carregando diagrama
O limite é a latência somada: em um exemplo ilustrativo, cinco agentes de 2 segundos levam pelo menos 10 segundos, o que pesa quando o cliente espera no chat.
Mesh: colaboração descentralizada
Cada agente pede informação diretamente a outro, sem orquestrador central.
Carregando diagrama
Paraleliza bem, mas é o mais difícil de depurar e exige controle de concorrência. Em atendimento ao cliente, raramente compensa.
Quais camadas uma arquitetura de orquestração precisa ter?
Qualquer que seja o padrão, sistemas que chegam à produção têm cinco camadas. O modelo de linguagem é só uma peça delas, como mostra o post sobre modelos de IA como commodity.
- Captura de intenção: extrai intenção, entidades, urgência e tom, e normaliza mensagens de canais diferentes (WhatsApp, site, e-mail, Teams, voz) em um formato único.
- Memória e contexto: curto prazo (a conversa atual) e longo prazo (o histórico do cliente). Sem ela, o cliente se reapresenta a cada contato. Veja memória conversacional.
- Planejamento: o orquestrador recebe intenção, contexto e estado e decide quais agentes ativar, em que ordem e com que paralelismo.
- Execução: cada especialista tem instruções, ferramentas e base de conhecimento do seu domínio, e critérios claros de quando terminou ou deve escalar.
- Governança: permissões, guardrails, limites de ação (nenhum reembolso acima de um valor sem aprovação humana), logs auditáveis. Mais em governança de IA no atendimento.
Exemplo ponta a ponta: segunda via e contestação de cobrança
Um bom teste de arquitetura é um pedido com duas intenções. O cliente escreve no WhatsApp: "Preciso da segunda via da fatura e não reconheço a cobrança de R$ 89". Um fluxo ilustrativo com orquestração:
- O orquestrador identifica duas intenções: segunda via e contestação.
- Dispara duas consultas em paralelo (faturas no sistema financeiro e histórico no CRM), cada uma com timeout de poucos segundos.
- Se uma consulta falha, faz retry idempotente (repetir a chamada não duplica o efeito). Se continuar falhando, avisa o cliente e registra a pendência.
- O agente de cobrança envia a segunda via. A contestação é uma ação de impacto, então é escalonada: o atendente recebe o resumo do pedido, do que foi consultado e do que já foi enviado.
- Todas as etapas ficam em log auditável.
O passo 2 é onde a execução paralela faz diferença. Em vez de esperar uma consulta terminar para começar a outra, o orquestrador dispara as independentes ao mesmo tempo:
import asyncio

# Sequencial: 3 tarefas x 2 s cada = 6 s no total
resultado_crm = consultar_crm(cliente_id)          # 2 s
resultado_pedido = consultar_pedido(pedido_id)      # 2 s
resultado_historico = buscar_historico(cliente_id)  # 2 s

# Paralelo: 3 tarefas simultâneas = cerca de 2 s no total
async def consultar_tudo(cliente_id, pedido_id):
    return await asyncio.gather(
        consultar_crm(cliente_id),
        consultar_pedido(pedido_id),
        buscar_historico(cliente_id),
    )
Os tempos são ilustrativos, e paralelizar só vale para consultas sem dependência entre si.
Onde entra o humano no circuito?
O humano entra em pontos definidos antes de a IA agir: quando a confiança é baixa, quando a ação tem impacto alto, quando o cliente pede ou quando o assunto está fora do escopo. Esse modelo se chama human-in-the-loop, e projetar esses pontos é tão importante quanto escolher o padrão de orquestração.


Os gatilhos de transferência devem ser explícitos e configuráveis pela operação:
- Confiança baixa: o agente não tem certeza da intenção ou da resposta.
- Ação de impacto: contestação, cancelamento, reembolso acima de um valor.
- Emoção intensa: cliente claramente irritado ou em situação delicada.
- Pedido explícito: o cliente quer falar com uma pessoa.
- Fora do escopo: assunto que nenhum agente foi configurado para tratar.
Quem assume recebe o que o cliente quer, o que já foi tentado e por que a IA parou, sem fazer o cliente repetir tudo. As 7 regras de handoff da IA para o humano detalham como calibrar isso.
Quais são os desafios reais de escalar sistemas multiagente?
Os problemas que derrubam projetos multiagente quase nunca aparecem no protótipo: surgem com volume, com dados reais e com sistemas que falham. Quatro se repetem.
- Amplificação de erros: com um agente, um erro afeta uma conversa. Com vários, um plano errado do orquestrador se espalha por todos os agentes que ele aciona. Cada agente deve validar a própria entrada antes de agir.
- Estado distribuído: agentes em paralelo na mesma requisição precisam de controle de concorrência para não gravar dados contraditórios.
- Observabilidade: uma requisição que passa por quatro agentes vira um grafo de execução, não uma linha. Sem rastreamento por passo, depurar vira adivinhação.
- Custo de execução: cada agente ativado consome tokens e chamadas. Orquestradores que acionam agentes "por garantia" ficam caros sem melhorar a resposta.
Há ainda quem mantém o sistema: quando a política de cobrança muda, quem atualiza o agente costuma ser a operação, não a engenharia. Sem uma interface que ela consiga usar, cada ajuste vira chamado técnico.
Checklist de produção: o que conferir antes de colocar agentes no ar
Um sistema de agentes está pronto para produção quando cada passo é rastreável, cada ação tem limite e cada falha tem um caminho de saída. Use a tabela como lista de verificação antes do lançamento.
| Item | O que conferir | Sinal de alerta |
|---|---|---|
| Observabilidade | Log por passo e por agente, com entrada, saída, ferramenta chamada e tempo | Você só vê a resposta final, não o caminho |
| Guardrails | Assuntos proibidos, dados que não podem sair e ações que exigem aprovação, reforçados fora do prompt | O limite existe só no texto das instruções |
| Timeouts e retries | Tempo máximo por chamada, retry idempotente e mensagem ao cliente quando o sistema cai | O cliente fica sem resposta quando uma API demora |
| Custo | Custo por conversa e por agente, limite de chamadas por conversa | Agentes acionados em toda mensagem "por garantia" |
| Humano no circuito | Gatilhos de transferência escritos, fila certa e resumo para quem assume | O atendente pergunta de novo o que o cliente já disse |
| Permissões | Cada agente acessa só os sistemas e as ações do seu domínio | Um agente de dúvidas consegue alterar cadastro |
| Avaliação | Conversas de teste antes de publicar e revisão de casos transferidos | Mudança de prompt vai direto para produção |
Para as integrações, o mesmo cuidado vale: um agente sem acesso aos sistemas responde só o que está no texto, como explica IA sem integração vira FAQ.
Frameworks e protocolos: como escolher
O framework certo é o que seu time consegue operar e observar, não o mais citado do trimestre. Os principais, conforme a documentação oficial consultada em 18 de novembro de 2026:
- LangGraph: framework de orquestração de baixo nível para agentes de longa duração e com estado, com persistência, pausa para revisão humana e memória.
- CrewAI: combina Crews (equipes de agentes com papéis) e Flows (estado e controle de execução, com condições e ramificações).
- OpenAI Agents SDK: poucas primitivas (agentes, handoffs entre agentes e guardrails), com rastreamento embutido.
- Microsoft Agent Framework: sucessor direto do AutoGen e do Semantic Kernel, feito pelas mesmas equipes, com workflows em grafo; em .NET e Python, com Go em prévia. A versão 1.0 chegou à disponibilidade geral em 3 de abril de 2026, segundo a Microsoft.
- Claude Agent SDK: as ferramentas, o loop de agente e o gerenciamento de contexto do Claude Code em Python e TypeScript, com subagentes, permissões e MCP.
Dois protocolos abertos ligam essas peças. O MCP (Model Context Protocol), lançado pela Anthropic em novembro de 2024, padroniza como aplicações de IA se conectam a ferramentas e dados; veja o verbete MCP. O A2A (Agent2Agent), criado pelo Google, padroniza a conversa entre agentes de fornecedores diferentes e virou projeto da Linux Foundation em 23 de junho de 2025.
Na escolha, pese a linguagem do time, a necessidade de estado e ciclos, a observabilidade de cada passo e a integração com seus modelos e sua nuvem. E pergunte antes: um agente só, ou um workflow determinístico, já resolve? Se as tarefas são previsíveis e de um domínio só, a orquestração multiagente acrescenta custo sem ganho. O guia agente único vs multiagente traz os critérios e uma tabela de decisão.
Construir ou contratar: quanto custa manter uma pilha de orquestração?
Construir com um framework compensa quando a orquestração é o produto; para atender clientes, quase sempre sai mais caro manter do que contratar. O framework resolve a coordenação entre agentes, mas a operação de atendimento precisa de muito mais em volta dele.
| O que a operação precisa | Construindo com um framework | Em uma plataforma de CRM conversacional |
|---|---|---|
| Canais (WhatsApp oficial, site, e-mail, voz) | Integrar e manter cada canal | Prontos na plataforma, com o WhatsApp pela API oficial |
| Memória e histórico do cliente | Projetar banco, sessão e retenção | Histórico no CRM da plataforma |
| Conexão com sistemas internos | Escrever e manter cada conector | Conectores, requisição HTTP, webhooks e MCP |
| Transferência para pessoas | Construir fila, tela do atendente e resumo | Transferência com histórico e resumo |
| Ajustes de política no dia a dia | Pedido para engenharia a cada mudança | A operação ajusta instruções e regras |
| Logs e auditoria | Montar rastreamento e exportação | Registro de atividades e histórico de execuções |
O custo de construir inclui as pessoas que mantêm a pilha, as trocas de modelo e as mudanças de API dos canais. O guia quanto custa implementar um agente de IA detalha essas linhas de custo, e os planos da Tolky estão em /precos.
O papel da Tolky: orquestração pronta para a conversa com o cliente
A Tolky é um AI CRM conversacional: agentes de IA configurados por missão (suporte, vendas e relacionamento, engajamento) atendem no WhatsApp pela API oficial, no site, por e-mail, no Microsoft Teams e por voz, com Fluxos de automação, CRM próprio e transferência para a equipe. A orquestração que este guia descreve vem pronta para esse tipo de conversa, e a operação configura o comportamento sem programar.
No exemplo da segunda via e da contestação, cada peça tem um correspondente na plataforma:
- Quem entende o pedido: um agente de suporte, com instruções e base de conhecimento da empresa, identifica as duas intenções.
- Quem consulta os sistemas: os Fluxos chamam o sistema financeiro por requisição HTTP ou por um dos mais de 1.000 apps do nó Integração (em liberação gradual por conta), e webhooks deixam outros sistemas acionarem o fluxo; o agente também usa ferramentas MCP. A lista completa está em integrações.
- Quem decide o caminho: o passo Decisão (se / então) e o passo Agentes, que põe a IA só onde você quer.
- Quem leva ao humano: regras de transferência escritas em linguagem natural ("contestação de cobrança vai para o financeiro") e o passo Transferir para humano, que pausa a IA e entrega o histórico e o resumo da conversa.
- Onde fica o registro: o CRM da Tolky guarda contato e histórico; o histórico de execuções mostra a saída de cada passo, e o registro de atividades pode ser exportado.
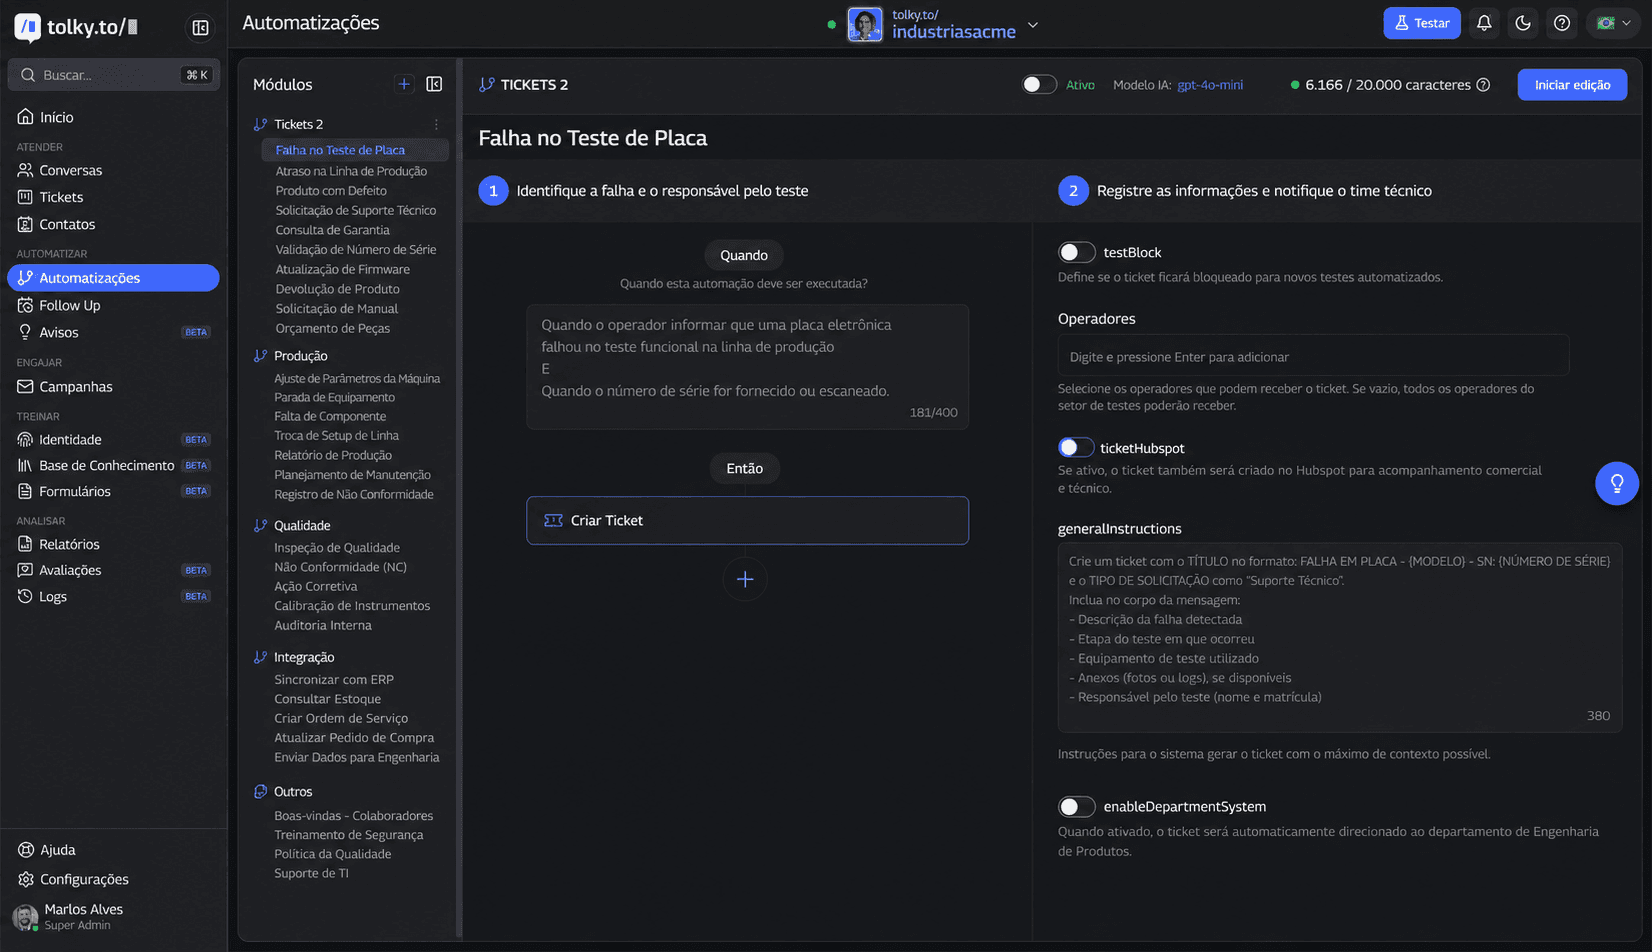
Quem é técnico conecta sistemas, APIs e ferramentas MCP; a operação escreve instruções, regras de transferência e políticas, sem precisar saber se o padrão é hierárquico ou mesh.
O que a Tolky não é: um framework de desenvolvimento para montar qualquer grafo de agentes em código. Se o seu caso é pesquisa autônoma, processamento de documentos em lote ou agentes que escrevem software, LangGraph, CrewAI ou um Agent SDK são o caminho. A integração nativa de CRM é só com o HubSpot (não há Salesforce nativo); outros sistemas entram por API REST, webhooks e requisição HTTP, como explica o guia de integração com sistemas legados, CRM e ERP.
Perguntas frequentes
O que é orquestração de agentes de IA?
É a coordenação de vários agentes de IA especializados por um orquestrador, que decide qual agente age, em que ordem, com qual contexto e quando chamar uma pessoa. O objetivo é resolver pedidos que um agente só faria mal, como uma conversa com duas intenções e sistemas diferentes.
Quando um agente só é suficiente?
Quando as tarefas são previsíveis e de um domínio só, como responder dúvidas de um produto com uma base de conhecimento. Vários agentes acrescentam latência, custo e pontos de falha. Comece com um agente bem integrado e divida só quando os domínios exigirem conhecimento, ferramentas ou permissões diferentes.
Qual padrão de orquestração usar no atendimento ao cliente?
O hierárquico, com um supervisor que identifica a intenção e delega a especialistas, é o mais adequado para atendimento. É fácil de auditar e cada especialista pode ser testado sozinho. O mesh raramente compensa quando o cliente espera a resposta.
Qual a diferença entre MCP e A2A?
O MCP padroniza como uma aplicação de IA acessa ferramentas e dados externos, como um CRM ou um banco de dados. O A2A padroniza a comunicação entre agentes, inclusive de fornecedores diferentes. Os dois são abertos e complementares.
Como evitar que um sistema multiagente fique caro?
Meça o custo por conversa e por agente, limite as chamadas por conversa e acione um agente só quando a tarefa pedir. Revise os casos em que agentes foram acionados sem mudar a resposta.
A Tolky substitui frameworks como LangGraph ou CrewAI?
Não, e não é essa a proposta. A Tolky é uma plataforma de CRM conversacional com agentes, Fluxos, integrações e transferência para pessoas, feita para conversas com clientes. Para orquestração de uso geral em código, como pesquisa ou processamento de documentos, um framework é a escolha certa.
Próximos passos
Orquestração de agentes de IA é o passo natural depois do primeiro agente, quando os pedidos envolvem vários sistemas, decisões e pessoas. Para atender clientes, compare o custo de manter essa pilha com o de uma plataforma que já entrega agentes, Fluxos, CRM e transferência com contexto. Vamos conversar?
Veja os planos, conheça as integrações, veja o CRM da Tolky ou fale com o time →
Compartilhar
Tags
- orquestração de agentes de IA
- sistema multiagente
- arquitetura de agentes
- human-in-the-loop
- MCP
- frameworks de agentes
- agentic AI
- #CRM conversacional
Citado em
- Tendências de IA agêntica para 2027: as 10 que vão mudar empresas
- Arquitetura de agente único ou multiagente: como escolher a certa
- Modelos de IA viram commodity: o diferencial agora é a operação
- Automação de atendimento sem perder humanidade: IA que atende melhor
- Integração de IA com sistemas: por que IA sem CRM vira FAQ
- Customer Experience (CX) em 2026: estratégias, ferramentas e IA
- O que é um agente de IA? Guia sobre agentes autônomos (2026)
- 4 milhões de mensagens com IA por mês e a infraestrutura por trás
- O que é Agentic AI e Por Que Vai Redefinir a Automação Empresarial
- Plataforma de automação empresarial com IA: como escolher
- Segurança e Privacidade de Dados em Plataformas de IA Enterprise
Sobre o autor

Cofundador da Tolky
Marlos Carmo é empreendedor em IA e fundador da Tolky, a infraestrutura e AI CRM da era conversacional que unifica atendimento inteligente, multicanalidade (como WhatsApp e voz), CRM vivo e inteligência operacional em um único ecossistema. É finalista do SXSW Innovation Awards e integrante do Francesco's Economy, rede global de jovens empreendedores com foco em inovação e impacto social. Atua conectando Inteligência Artificial e transformação digital em projetos para grandes organizações.
Próximo passo
Quer levar isso para a sua operação?
A Tati, assistente de IA da Tolky, entende o seu cenário em poucas perguntas, sugere o melhor caminho e te conecta com uma pessoa do time levando todo o contexto.
Compartilhar